Deutsch
 Türkçe
 English
 Français
 العربية
 Русский
 Español
 Polski
In der Datenanalyse
Neue Ära
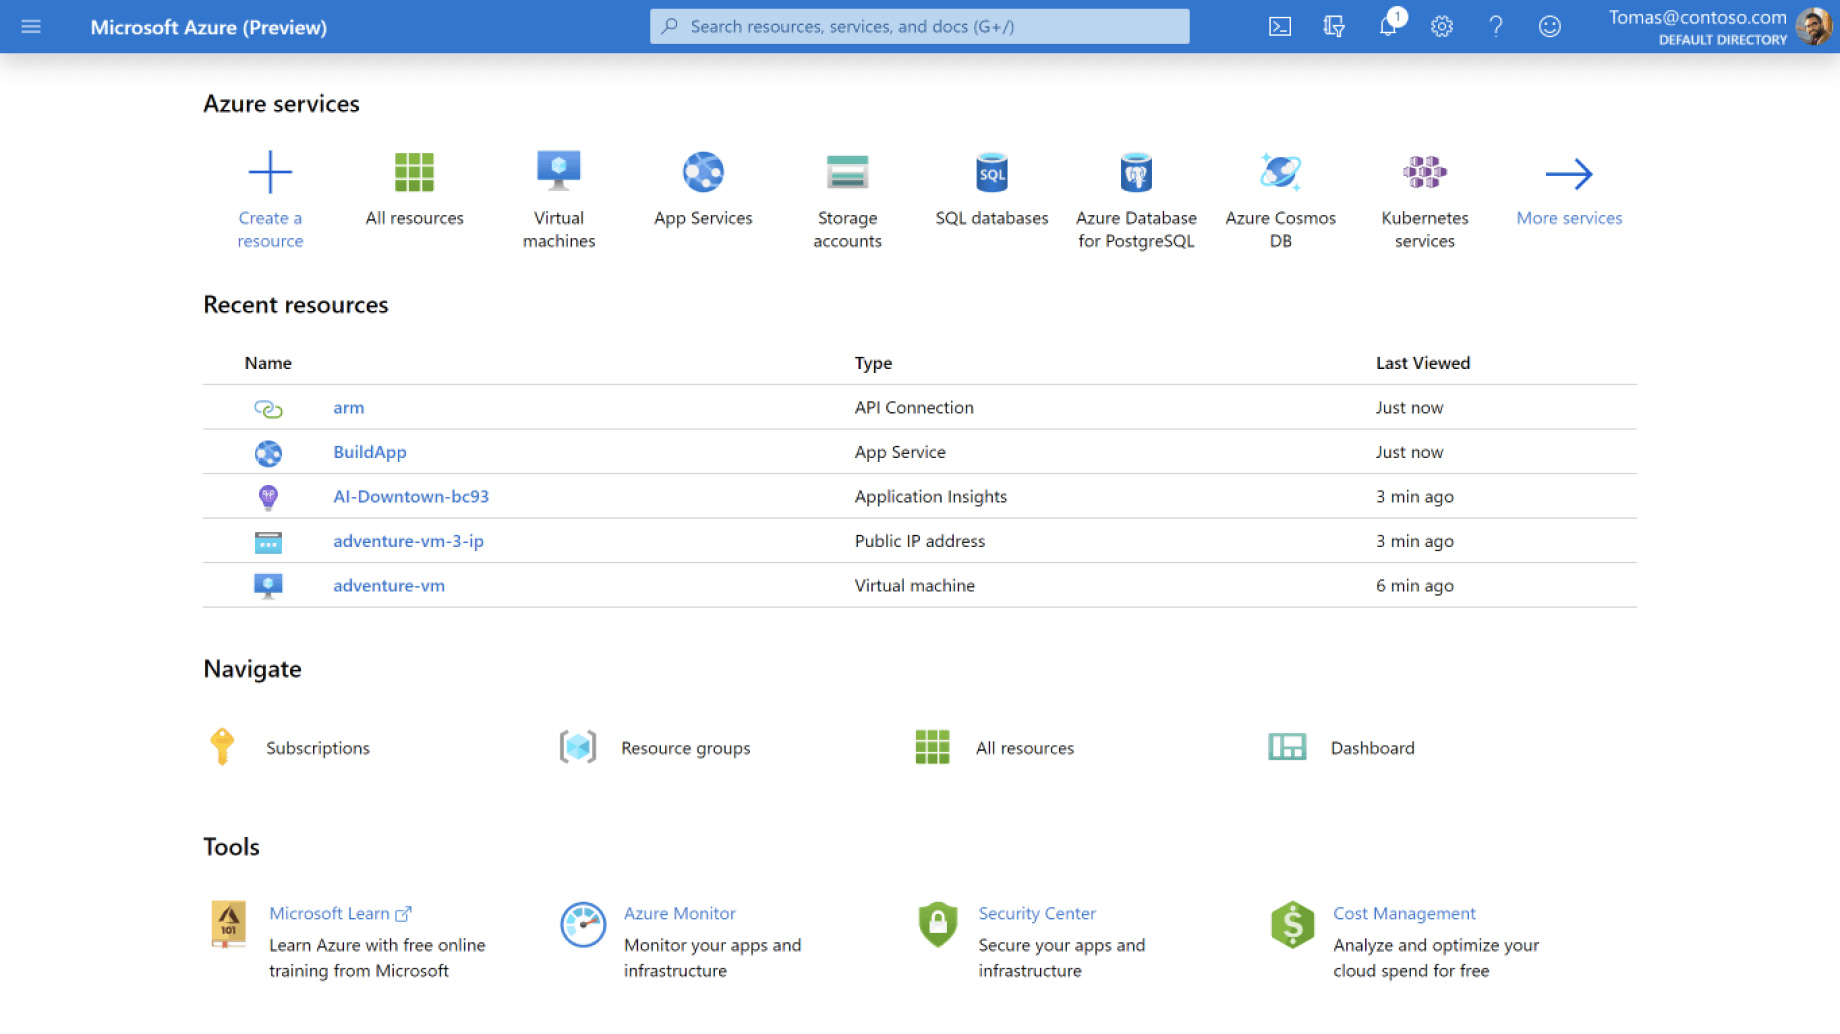
Microsoft Fabric ist eine Lösung der nächsten Generation, die alle Datenanalyse-Workloads auf einer einzigen SaaS-Plattform vereint. Statt unterschiedlicher Tools, unterschiedlicher Lizenzen und komplexer Integrationen – eine Plattform, ein See, ein Sicherheitsmodell.
- OneLake: Ein einziger Datensee für alle Daten
- 7 integrierte Workloads (Data Engineering → Power BI)
- Flexible Preisgestaltung basierend auf der Kapazität (CU)
- Einheitliche Sicherheit mit Microsoft Entra ID
- Copilot KI-gestützte Datenerkennung und -analyse
- Vollständige Integration mit Azure, M365 und Power Platform
Fabric 7
Integrierte Arbeitslast
Speziell für jede Phase des Datenlebenszyklus entwickelt,
Erlebnisse, die sich nahtlos ineinander integrieren.
Datentechnik
Transformieren und bereiten Sie große Datensätze mit der Lakehouse-Architektur auf Basis von Apache Spark vor.
Datenfabrik
Erstellen Sie ETL/ELT-Pipelines mit über 150 Konnektoren. Orchester Sie Datenmigrations- und Transformationsprozesse.
Datenwissenschaft
Erstellen, trainieren und implementieren Sie Modelle für maschinelles Lernen in einer MLflow-unterstützten Notebook-Umgebung.
Data Warehouse
T-SQL-kompatibles, automatisch skalierbares Data Warehouse. Datenbankübergreifende Abfragen und Zeitreiseunterstützung.
Echtzeit-Intelligenz
Echtzeitanalyse von Milliarden von Ereignissen mit KQL. Ideal für IoT, Protokoll und Telemetrie.
Power BI
Erstellen Sie interaktive Dashboards und Berichte direkt auf Fabric-Daten. Sofortiger Zugriff mit Direct Lake-Modus.
Datenaktivator
Erkennen Sie Datenänderungen automatisch und lösen Sie bedingte Aktionen aus – ohne Code schreiben zu müssen.
OneLake
Architektur
Einziger Datensee für alle Fabric-Workloads. Eliminieren Sie separate Silos,
Speichern Sie Ihre Daten einmal und greifen Sie von überall darauf zu.
OneLake
Einziger ADLS Gen2-basierter Datensee für alle Fabric-Workloads
Fabric vs.
Traditioneller Ansatz
| Kriterium | Konventionell (diskrete Fahrzeuge) | Microsoft Fabric |
|---|---|---|
| Datenspeicherung | Separate Speicherung und Datenkopie für jedes Fahrzeug | OneLake – einzelner Datensee, Zugriff über Verknüpfungen |
| Lizenzierung | Separate Lizenz und Preise für jedes Produkt | Basierend auf Einzelkapazität (CU), inklusive aller Workloads |
| Sicherheit | Separate Sicherheitskonfiguration für jedes Fahrzeug | Kombinierte Entra-ID, Purview und Vertraulichkeits-Tags |
| ETL / Datenpipeline | Verschiedene Orchestrierungstools (SSIS, Airflow etc.) | Integrierte Data Factory, über 150 Konnektoren, Dataflows Gen2 |
| Data Warehouse | Dedizierter SQL-Pool, zusätzliche Verwaltung | Serverlos, T-SQL, automatische Skalierung |
| Echtzeitanalyse | Azure Data Explorer → separate Ressource/Lizenz | Integrierte Echtzeit-Intelligenz, KQL, Eventstreams |
| Berichterstattung | Separate Power BI-Verbindung, Import/DirectQuery | Direct Lake – Lesen aus Lakehouse ohne Abschreiben |
| KI & Copilot | Begrenzte oder externe Integration | Integrierter Copilot, automatische Codegenerierung, Datenanmerkung |
| Regierungsführung | Separate Herkunftsverfolgung für jedes Fahrzeug | Central Purview-Integration, Datenstammbaum |
Fabric
SKUs
Skalierbare Kapazitätseinheiten (CU) entsprechend Ihrem Bedarf.
Alle Workloads teilen sich einen einzigen Kapazitätspool.
| Artikelnummer | Kapazitätseinheit (CU) | Power BI | Maximaler RAM (Spark) | Nutzungsszenario |
|---|---|---|---|---|
| F2 | 2 CU | - | 4 GB | PoC, Entwicklungsumgebung |
| F4 | 4 CU | - | 8 GB | Kleine Teams, Tests |
| F8 | 8 CU | EM1-Äquivalent | 16 GB | Abteilungsebene |
| F16 | 16 CU | EM2-Äquivalent | 32 GB | Mittelständische Organisationen |
| F32 | 32 CU | P1-Äquivalent | 64 GB | Unternehmens-Workloads |
| F64 | 64 CU | P2-Äquivalent | 128 GB | Big-Data-Analyse |
| F128 | 128 CU | P3-Äquivalent | 256 GB | Große Institutionen |
| F256+ | 256+ CU | P4+-Äquivalent | 512+ GB | Projekte im Petabyte-Bereich |
* Für mehr als 40 % der Azure-Reservierungen auf SKUs F64 und höher verfügbar.
Fabric
Beratung
Als Microsoft CSP-Partner bieten wir End-to-End-Support für Ihre Fabric-Projekte. Vom Architekturentwurf bis zur Bereitstellung, von der Schulung bis zur Kostenoptimierung.
- Fabric-Arbeitsbereich und Kapazitätsplanung
- OneLake Architectural Design & Shortcuts-Strategie
- Datenpipeline und Lakehouse-Setup
- Migration von vorhandenen Synapse/Databricks zu Fabric
- Optimierung des Power BI Direct Lake-Modus
- Echtzeit-Intelligenz und KQL-Setup
- Aktivierung und Schulung des Fabric Copiloten
- SKU-Optimierung und Reservierungsmanagement
Mit Fabric
Was kann getan werden?
Modernisierung des Data Warehouse
Serverloses, automatisch skalierbares modernes Data Warehouse mit SSIS + SQL Server DW → Fabric Data Warehouse + Data Factory.
Echtzeit-IoT-Analyse
Analysieren Sie Millionen von Sensordaten in Sekundenschnelle mit Event Hubs → Eventstreams → KQL-Datenbank.
Einheitliche Berichterstattung
Erstellen Sie Power BI-Berichte direkt aus Lakehouse-Daten ohne Import/Kopieren mit dem Direct Lake-Modell auf OneLake.
ML-Modellentwicklung
Trainieren Sie MLflow-, Scikit-Learn- und PyTorch-Modelle mit Data Science-Erfahrung und stellen Sie sie mit MLOps in der Produktion bereit.
Multi-Cloud-Datenintegration
Greifen Sie mit OneLake Shortcuts auf AWS S3-, Google Cloud Storage- oder ADLS-Daten zu und analysieren Sie diese, ohne sie zu kopieren.
Automatische Aktionsauslösung
Initiieren Sie mit Data Activator automatische Benachrichtigungen und Aktionen in Fällen wie niedrigem Lagerbestand, Anomalieerkennung oder SLA-Verletzung.
Häufig fragte
Fragen